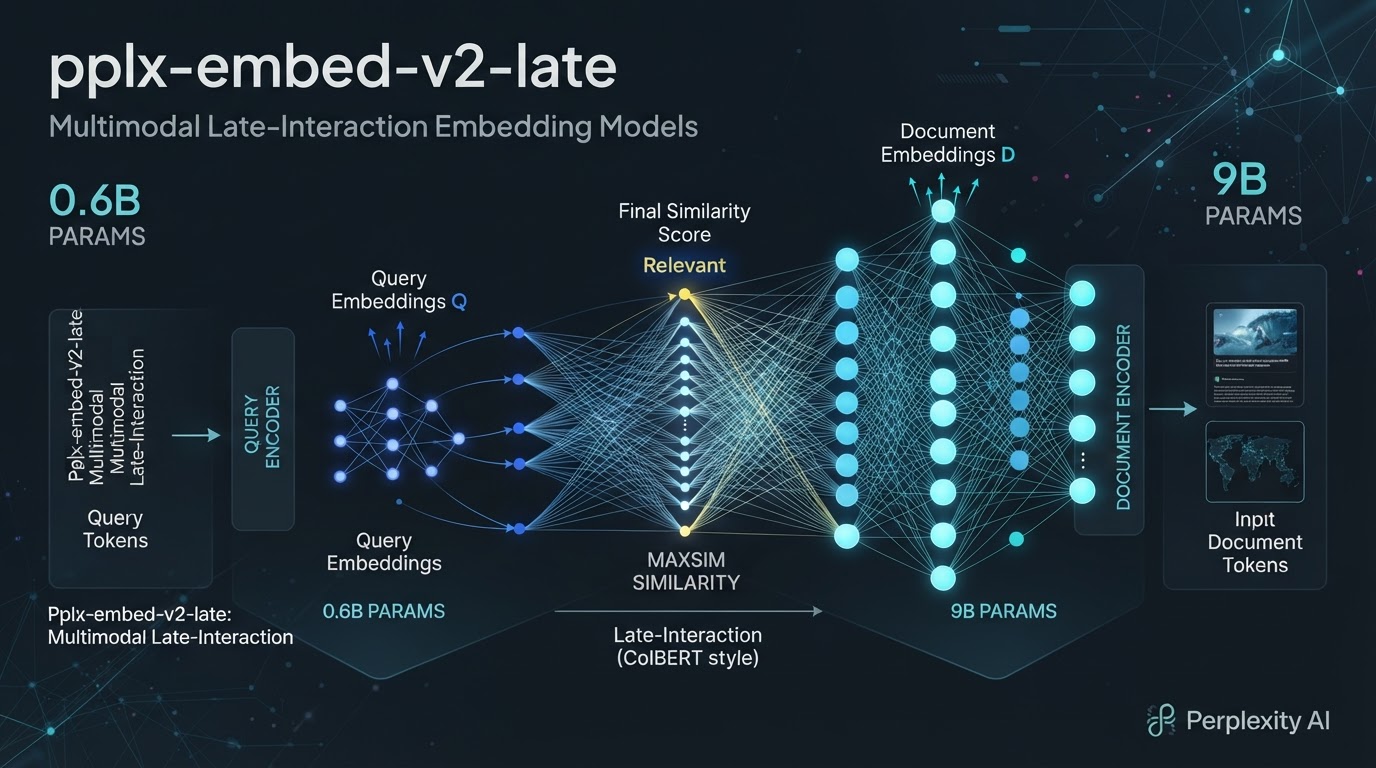
Perplexity 於 2026 年 10 月 7 日在官方網誌發表 pplx-embed-v2-late 系列嵌入模型,包含 0.6B 與 9B 兩個版本。這批模型採用 ColBERT 式 late-interaction 架構,同時支援文字與圖片檢索,並共用同一個嵌入空間,權重已上傳至 Hugging Face[1][2].
由單一向量走向 late interaction
Perplexity 在文中解釋,檢索系統必須在效率與查詢文件之間的互動深度之間取得平衡。稠密嵌入模型把查詢與文件各自獨立編碼,可以用內積比較,令近似最近鄰搜索在數十萬文件規模上變得可行;交互編碼器把查詢與文件一併處理,互動更豐富,但每次查詢文件都要獨立一次前向傳播,成本高昂,通常只用於為少量候選重新排序[1].
Perplexity 指出,用單一固定長度向量代表整份文件會造成資訊瓶頸:文件越長、主題越多,要涵蓋的內容就越多。這個問題在多模態場景更嚴重,因為圖片的資訊密度需要更大的涵蓋。此外,單向量檢索把每次比較化約為兩個向量的內積,限制了判別函數的表達能力[1].
pplx-embed-v2-late 採取中間路線。模型為輸入的每一個 token 輸出一個一百二十八維向量,再用 MaxSim 為查詢與文件評分:對每個查詢 token,模型選出得分最高的文件 token,再把這些逐 token 的最大相似度相加成為最終分數。這樣查詢的不同部分可以對應文件的不同部分,相似度高的 token 對分數貢獻更大[1].
兩種尺寸共用同一個嵌入空間
這個系列提供 0.6B 與 9B 兩個尺寸,各有不同品質、延遲與運算需求。兩者皆可以獨立使用,且因為共用嵌入空間,可以用較小的模型查詢由較大模型建立的索引,把高品質的文件嵌入與便便快速的查詢推論結合起來[1].
Perplexity 特別說明 0.6B 版本的設計。它由 Qwen3.5-0.8B 出發,把二十四層的文本塔切斜至十二層,令喂塔的非嵌入參數由四千九百八十萬減至二千五百四十萬。模型總參數為五千九百五十四萬,但實際服務成本更低:一千個參數用於圖片編碼,二千五百四十萬個位於 token 嵌入表,對極行時間影響輕微,真正活躍的文本編碼參數約為二千五百四十萬,圖片編碼約為三千五百四十萬[2].
Hugging Face 模型卡顯示,0.6B 版本活躍參數為三千五百四十萬,9B 版本為七十四萬[2].
蒸餾方法與多語言數據量
模型以蒸餾方式訓練。Perplexity 先以對比學習蒸餾一個一千八百萬參數層別的 ColBERT 教師模型,再分別蒸餾成 9B 與 0.6B 兩名學生。蒸餾並非只是要求學生複製教師的排序分佈,而是採用 LEAF 式表達蒸餾:對每個輸入 token,把學生的輸出嵌入與教師對齊。這個做法過去只用於稠密單向量模型,Perplexity 把它延伸至 late interaction[1][2].
蒸餾數據量方面,兩個模型使用來自四十六種語言、五百五十四個數據集的 1.86 萬對查詢—文件配對。原始配對中八成八是文字對文字,八成九是文字對圖片,三成四是文字對視覺文件;Perplexity 為每個數據集設定抽樣權重,得出更平衡的蒸餾組合。公司亦排除與評測基準相關的數據集,以免基準分數被抬高[1].
基準表現與使用方式
在視覺文件檢索基準 ViDoRe(V3)上,Perplexity 稱 0.6B 模型的表現可以媲美活躍參數多五倍的模型。官方數據顯示,0.6B 在 ViDoRe v3 圖片任務取得百分之六十六十二九,9B 為百分之六十六五九二;在 Markdown 任務上分別為百分之六十六一二及百分之六十六四七[2].
在測試 agent 於真實 PDF 上問答的 MADQA 上,9B 模型配搭代理取得百分之九十二四準確度,比使用 Mixedbread 檢索器的同一代理高三成五個百分點,0.6B 模型為百分之九十九一[1].
使用方面,兩個模型已上傳至 Hugging Face,開箱相容 sentence-transformers 六釐零零或以上,以及 transformers 五釐四釐零或以上[2]。Perplexity 表示會在年內發表技術報告,並正蒸餾下一代的稠密嵌入模型,日後會逐步在 Perplexity API 平台推出 late-interaction、稠密與上下文嵌入的支援[2].
參考資料
[1] Multimodal embeddings beyond a single vector (2026-10-07)
[2] perplexity-ai/pplx-embed-v2-late-0.6b — Hugging Face 模型卡