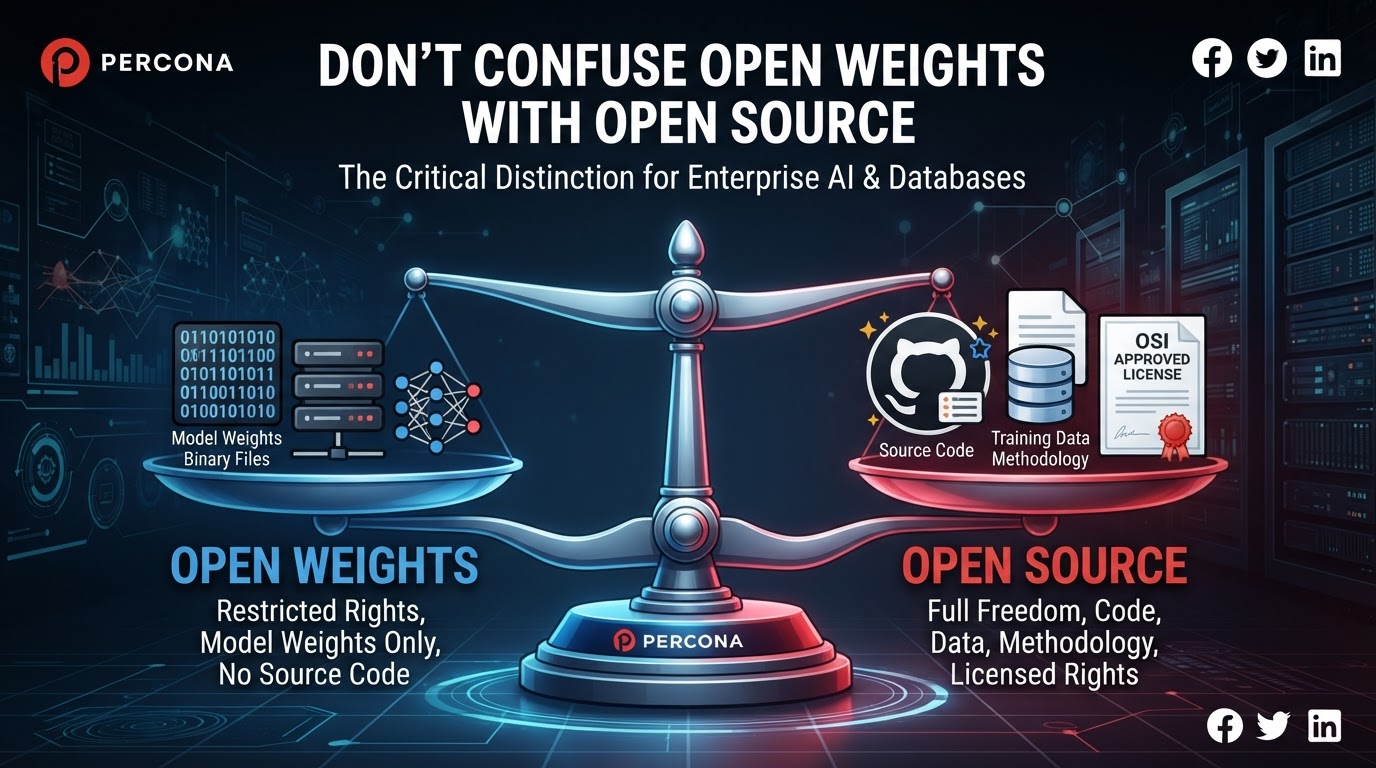
Percona 行政總裁 Peter Zaitsev 於 2026 年 10 月 8 日發表公開信,針對 AI 領域日益模糊的「開放權重」與「開放源碼」概念劃清界限。他強調:釋出模型權重(開放權重)≠ 開放源碼,混淆兩者會誤導用戶、稀釋開源定義、削弱社群治理。
核心區別:權重 vs 源碼
- 開放權重:僅發布訓練完成的模型參數檔案(.safetensors, .bin, .gguf),通常伴隨許可證限制商業用途、衍生模型、蒸餾。用戶獲得的是「黑盒」推理能力,無法理解、修改、審計訓練過程。
- 開放源碼:依照 OSI 開源定義,包含完整源碼(訓練腳本、數據處理管線、模型架構實現)、訓練數據集(或可復現的數據獲取腳本)、超參數配置、評測腳本、文檔。採用 OSI 認證許可證(Apache-2.0, MIT, BSD 等),保障使用、研究、修改、分發自由。
為什麼這很重要
- 可審計性:開放源碼允許第三方驗證訓練數據是否包含版權內容、個人隱私、偏見來源;開放權重無法追溯數據血統。
- 可修改性:真正的開源讓社群能修復 Bug、優化架構、適配硬體、延續維護;權重釋出者停止維護後,模型實際上成為廢棄軟體。
- 許可證合規:許多「開放權重」模型使用自定義限制性許可證(如 Llama 社區許可、Qwen 許可),實質上是「源碼可見但非開源」,與 OSI 定義背道而馳。
- 供應鏈安全:企業採用開源軟體可構建可信供應鏈(SBOM、簽名、可復現構建);權重二進位檔無法驗證是否植入後門、投毒樣本。
行業現狀與誤導
Zaitsev 指出,Meta (Llama)、阿里雲 (Qwen)、Mistral、Z.ai (GLM)、DeepSeek 等廠商發布模型時,常在標題、營銷材料中使用「開源」一詞,實則僅釋出權重。這造成:決策者誤以為擁有完整控制權、合規團隊按開源流程審核卻發現許可證限制、社群貢獻者期待參與協作卻發現無源碼可改。
Percona 的立場與建議
作為開源數據庫領域的領導者,Percona 呼籲:
- 媒體、分析師、決策者精確使用術語:「開放權重模型」而非「開源模型」
- 模型發布方在 README、Model Card、Hugging Face 標籤中明確標註許可證類型,勿使用 OSI 專屬標識
- 推動建立「開放權重」專屬分類標準,區別於 OSI 開源定義
- 企業採購 AI 模型時,將「源碼可用性」列為獨立評估維度
開源定義的演進挑戰
OSI 正在推進「開源 AI 定義」(OSAID),試圖將開源原則延伸至 AI 系統(數據、模型、權重、推理引擎)。Zaitsev 支持這項工作,但強調:在正式定義出台前,不應預先稀釋現有開源定義。真正的開源 AI 需要:訓練數據開放、源碼開放、權重開放、許可證符合 OSD——缺一不可。