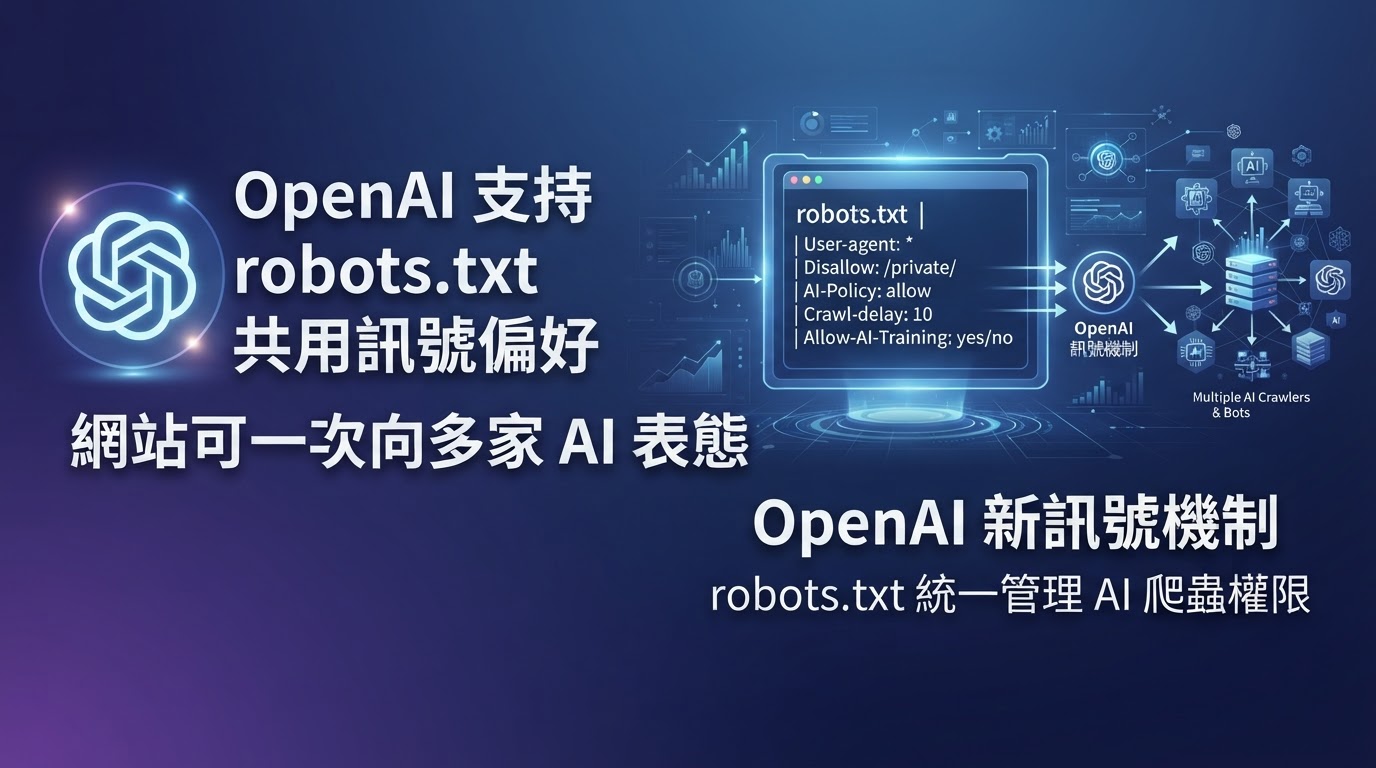
OpenAI 宣佈,將遵循一個放在 robots.txt 的共用訊號,讓網站營運者一次向多家參與的 AI 供應商表達「內容是否可用作基礎模型訓練」,不必再逐家 AI 公司辨識 crawler、逐條嵌規則[1]。公司表示目標在未來數月實施,屆時會再交代具體細節,並強調新訊號不會取代現有的 crawler 控制[1]。
從逐個 crawler 到一個共用訊號
現行做法之下,網站管理員要在 robots.txt 辨識每一家 AI 公司的抓取程式,為每個供應商分別絕護一條規則。OpenAI 在公告中承認,這種做法對網站營運者構成重複工作,而跨供應商的共用訊號正好減少這類負擔[1]。
這個訊號並非 OpenAI 單方設計,而是源自互聯網工程任務組(IETF)AI Preferences 工作組的討論。OpenAI 表示,這次是與工作組其他參與者一同公開,並認為這有助強化其在 IETF 標準討論中的參與[1]。公告又提到,新做法依賴工作組一條關於訊號偏好的互聯網草稿[1]。
技術上如何運作
根據草稿編碼 draft-kelley-aipref-training-preference-signal-00 的草稿,機制不需要新增任何指令名稱,也不改動 robots.txt 的語法:路徑詞語、最長匹配優先規則與群組結構一律沿用原有定義,只是在 User-Agent 一行改用一個按用途劃分的政策標記[2]。草稿舉例的寫法是:在 robots.txt 寫入 User-Agent: __usage_ai-training,再配合 Disallow: / 與 Allow: /press-kit/,即表達除 /press-kit/ 路徑以外,全站不願內容被用於 AI 訓練,而謂路徑規則表示贊成[2]。
這種設計的好處是向後兼容。草稿指出,未實作此機制的解析器,會把政策標記群組當作不認識的 user agent 群組忽略,行為與以往一致;反之言之,網站加入這個訊號,不會意外改變原有的流量管理規則[2]。同時,偏好可以按路徑逐段設定,不限於全站一刀切[2]。
自願性質與實際限制
OpenAI 明確表示,新訊號僅自願性質,不會取代現有的 robots.txt 控制;公司現有向網站提供的 crawler 控制將繼續適用並獲尊重[1]。公告又呼籲其他 AI 供應商一同遵循這個訊號[1]。
對出版商而言,這意味著多了一个集中表態的渠道,但約束力仍取決於各家供應商是否自願跟隨。訊號寫在 robots.txt,本身沒有法律強制力,實際效果要看參與名單有多廣、以及各家在訓練流程中如何處理。對中小型網站,甚至是無力逐家談判授權的出版方,一次設定即可向多家表態,操作成本明顯低於現時做法。
參考資料
[1] Making it easier for websites to express AI training preferences(2026-10-30)
[2] Machine-Readable Training Preference Signal(2026-10-30)