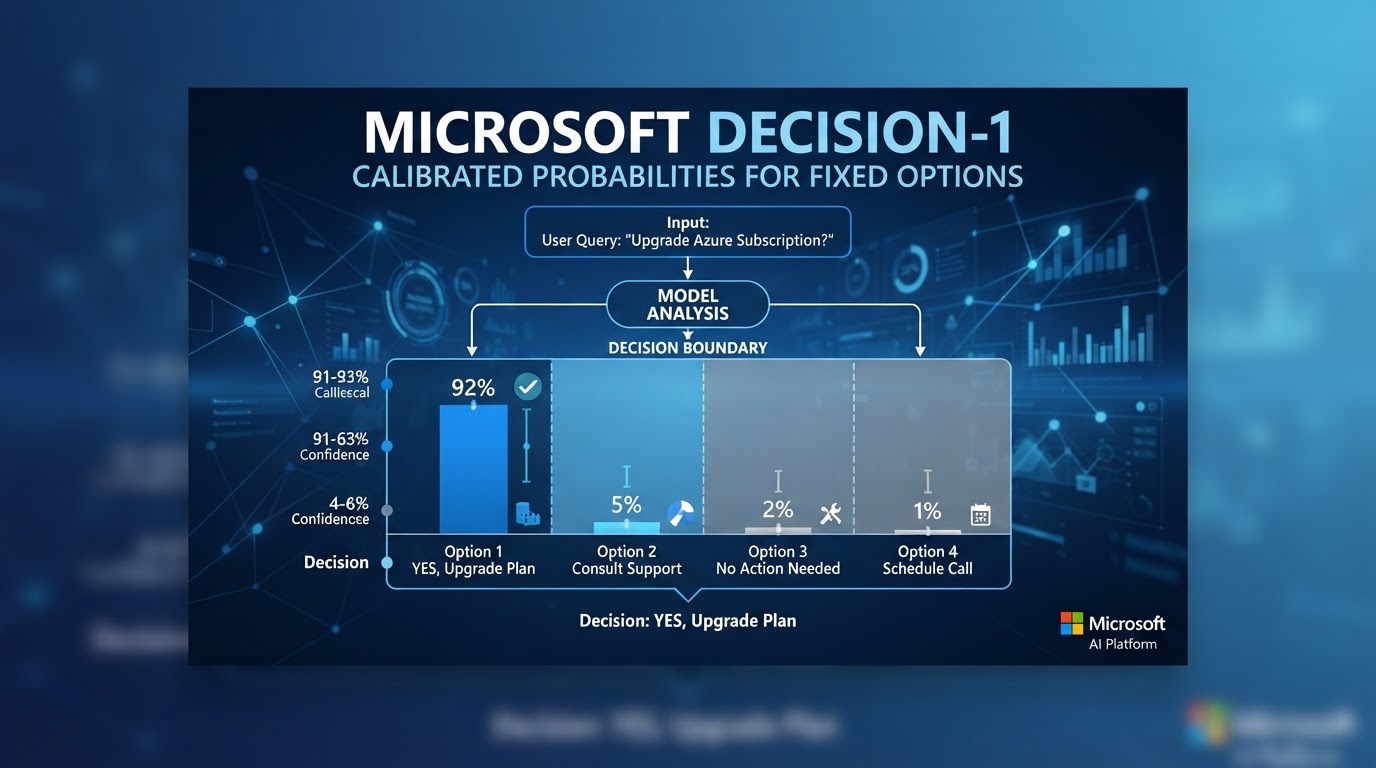
微軟研究院於 2026 年 10 月 8 日發表 Decision-1,一種全新範式的語言模型:它不生成文字,而是為固定選項輸出校正過的機率分佈。這項工作重新思考了語言模型在決策任務中的角色——從「生成式」轉向「判斷式」。
核心創新:機率校正的決策者
傳統 LLM 在多選題、分類、路由等決策任務上,通常採用生成式方式:讓模型輸出選項文字或推理過程,再解析答案。但這種方式存在校正問題——模型輸出的機率往往過度自信,且受提示詞、採樣溫度、上下文長度影響大。
Decision-1 直接輸出每個固定選項的校正機率 P(option|context),經過專門的校正訓練,確保輸出機率在統計意義上可靠:若模型輸出某選項 80% 機率,長期來看該選項確實約在 80% 情況下為正確答案。
架構設計
- 編碼器架構:基於 BERT/DeBERTa 風格的雙向編碼器,而非自回歸解碼器
- 固定輸出空間:輸出維度等於預定義選項數量,每個選項對應一個 logit
- 校正訓練目標:結合 focal loss、label smoothing、temperature scaling,並在驗證集上做後處理校正
- 不確定性量化:輸出熵值、互信息等不確定性指標,支援「拒絕決策」
適用場景
Decision-1 針對選項固定、需可靠機率的場景:
- 意圖分類/路由:客服系統將用戶查詢路由至專門處理器
- 內容審核:多類別違規檢測,需可審計的機率閾值
- 醫療/法律輔助決策:固定診斷選項,需校正信心度
- 多模型集成:作為元分類器融合多個專家模型預測
- 提示詞工程優化:快速評估不同提示詞對決策分佈的影響
效能優勢
在多個決策基準上,Decision-1 以顯著更小的參數量(~150M)達到或超越大型生成式模型的決策準確度,且推理延遲極低(單次前向傳播、無自回歸生成)。校正質量上,ECE (Expected Calibration Error) 降低 60-70%,顯著優於生成式基線的 temperature scaling 後處理。
對 AI 系統設計的啟示
Decision-1 提醒我們:並非所有 AI 任務都需要生成能力。對於「從固定選單選一個」的決策任務,專用的判斷式模型在準確度、校正度、延遲、可解釋性上都有根本優勢。未來的 AI 系統架構中,生成式模型負責開放式創作、推理、代碼生成;判斷式模型負責路由、分類、審核、決策——兩者協作,各司其職。
參考資料
[1] Decision-1: Calibrated Probabilistic Decision Making with Language Models (Microsoft Research)