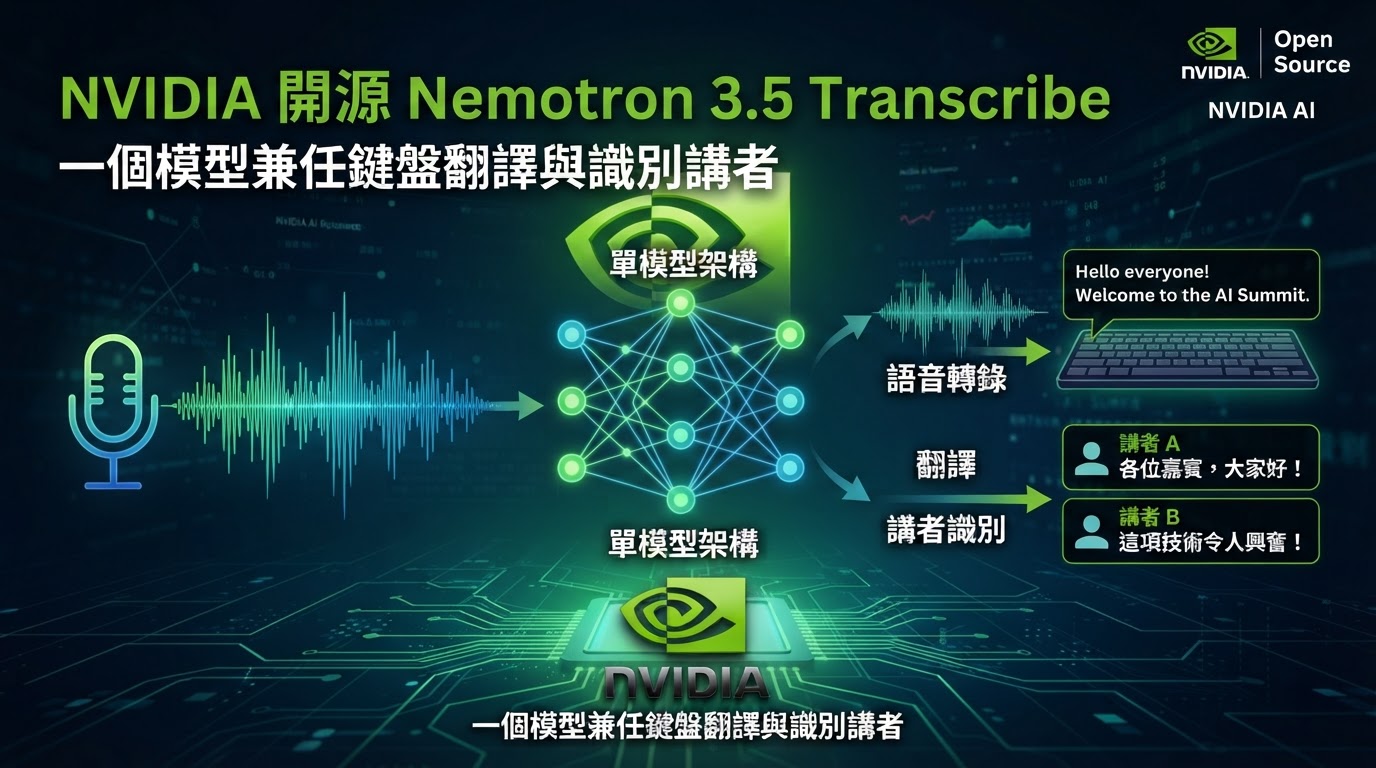
NVIDIA 於2026年10月28日發布 Nemotron 3.5 Transcribe,這是一個開放權重、可用自然語言指令引導的語音模型,已上架 Hugging Face 與 ModelScope[1]。模型支援40種語言翻譯、31種語言與英文互譯,以及13種語言的講者分離,可處理長達一小時、最多八位講者的錄音[1]。官方同步開源 Granary v2 數據流程與微調框架,讓開發者按行業詞彙自行調整[1]。
單一檢查檢驗多種輸出
NVIDIA 指出,同一段會議錄音可以按指令產生不同結果,例如要求逐字翻譯並標示講者、要求翻譯成英文,或直接詢問會議作出了哪些決定[1]。模型結合 Sortformer 講者線索與聲學特徵,在生成階段即標示每一句發言,而非事後另行講者釘回針[1]。遇到殘生詞語時,官方建議先在指令中列出候選詞並要求只在錄音支持時使用,而非立即重新訓練[1]。
開源組別排名與錯誤率
在 Hugging Face Open ASR Leaderboard 的英文組別,Nemotron 3.5 Transcribe 以平均5.33% 字錯率在開放權重模型中排第一,即時因子為462.09[1]。同一檔模型卡比較顯示,它在七種語言的多語組別平均字錯率為4.62%,長音頻組別為10.98%,兩者均為受評開放權重模型中最低[1]。
Artificial Analysis 的獨立評測中,它以約2.8% 的 AA-WER 與另一個開放權重模型並列第一,但活躍參考數約為40萬,對手為240萬;在語音代理指標一半的語音代理測試集 AA-AgentTalk 上,它的字錯率為1.8%,次佳開放模型為2.3%[1]。模型總參數量為300億,採用混合 Mamba 與 Transformer 的專家混合架構,每個 token 只啟動約40億參數[1]。
講者識別方面,它在 David AI 的21語言基準中整體講者分離錯誤率為18.26%,為14個受測系統中最低,險勝 NVIDIA 自家的 Nemotron 3 Diarization(18.38%)[1];在 VoiceArena 的英文完整會議比較中,它以32.4% 的 cpWER 排第一,漏字比率為8.32%,遠低於約31% 的中位數[1]。
Granary v2 與行業微調
Granary v2 以 NeMo Curator 建構,公開清洗涵蓋48種語言、16個來源語料,合共463,062小時,較第一版的25種語言大幅增加[1]。流程為每段錄音生成三種逐字稿格式,並附上短片說明、語碼翻譯還原、帶語音的問答對及翻譯[1]。
官方以印度鬆獅語音基準 Eka Care 示範調整效果。只在指令中嵌明英文與拉丁字母,已把整體字錯率由30.8% 降至23.8%;再以約153小時合成語音、29小時帶口音英語及63小時鬆獅錄音微調後,整體字錯率降至11.8%[1]。在未參與與調整的講者上,字錯率由最佳指令的22.44% 降至12.17%,減幅45.8%,且低於一個開放鬆獅專用模型的13.79% 以及一個通用語音模型的14.92%[1]。
部署方式與限制
NVIDIA 表示,使用即將推出的 NVFP4 量化版本,單張 RTX PRO 6000 Blackwell 伺服器版顯卡可在三分鐘內處理100小時音頻[1]。開發者現時可用 vLLM 或 SGLang-Omni 自行架設,量化版本稍後推出,屆時可在 RTX Spark、DGX Spark 及 Jetson AGX Thor 本機運作[1]。官方提醒模型針對已錄製音頻而設,並不支援即時串流,使用時須慮核對人名、講者交替及問答結果[1]。
參考資料
[1] NVIDIA Nemotron 3.5 Transcribe and Granary v2(2026-10-28)