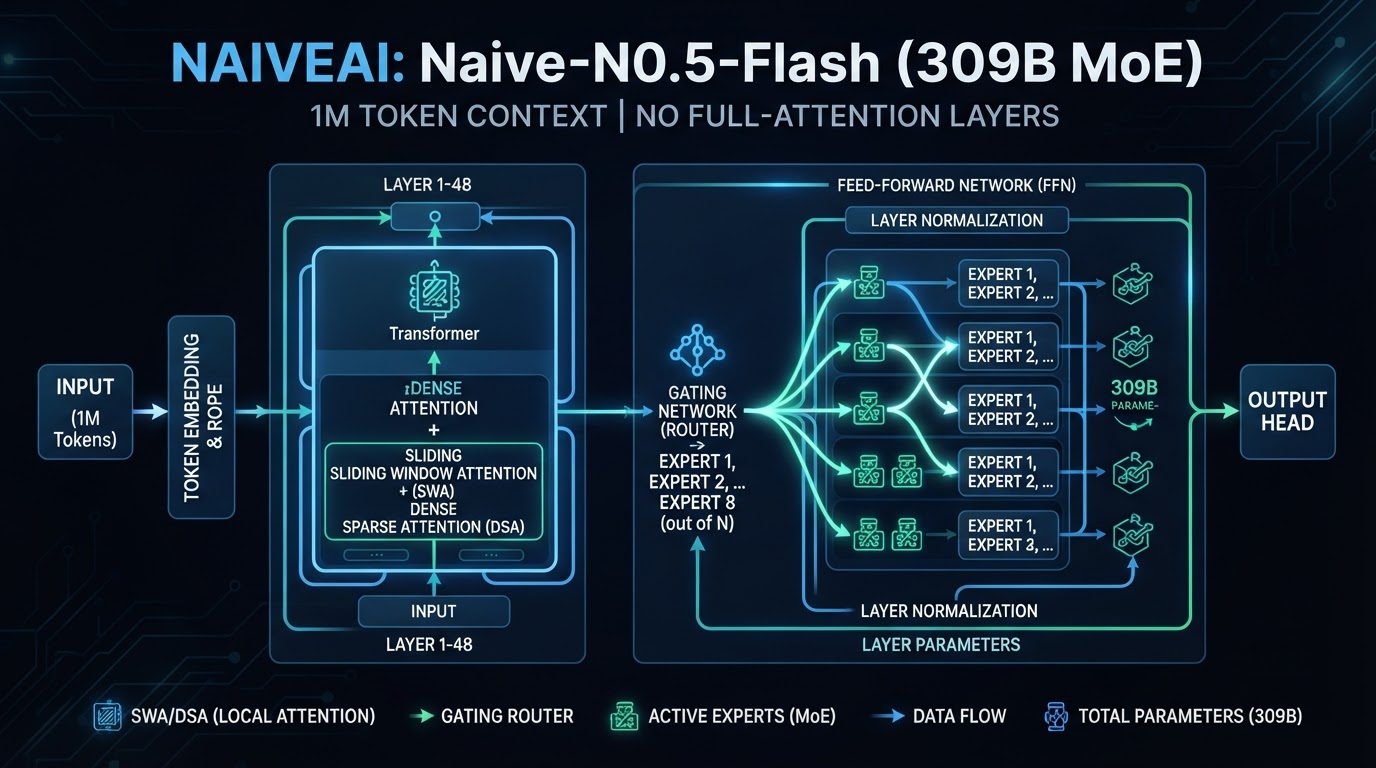
北京人工智能初創 NaiveAI 發布開放權重模型 Naive-N0.5-Flash,並在 Hugging Face 上傳模型卡與權重。官方描述這是一個 3090 萬參數的混合專家(MoE)模型,激活參數為 155 萬,為編程與人工智能研究而設,原生支援 100 萬 token 上下文,權重與推理程式碼以 MIT 授權釋出。[1]
架構設計
官方指出,模型的 100 萬 token 上下文並非依賴 full attention,而是結合滑動視窗注意力(SWA)與輕量級 DeepSeek 稀疏注意力(DSA),以約 5:1 的 SWA 對 DSA 比例配合 GQA4,整個網絡保持在局部或稀疏運算,沒有任何 full-attention 層。[1]
模型列出的規格為:48 層 Transformer、注意力層組成 39 層 SWA 加 9 層 DSA、SWA 視窗 128 token、DSA 為顱骨注意力選取前 2,048 個 token、4 個 KV 群組(GQA4)與 16 個索引器查詢頭。官方解釋,網絡由八個六層模組組成,標準模組為五層 SWA 接一層 DSA,而首個模組的第一層也改為 DSA;兩種注意力均包含 sink bias。與原始以 MLA 為基礎的 DSA 實作不同,此模型改用具四個 KV 群組的分組查詢注意力。[1]
訓練過程
官方指出,模型建基於開放的 MiMo-V2.5 基礎模型,釐模型結構簡簡而在世界知識與深度研究方向基礎能力較強。由於在百萬 token 上下文長度下,全局注意力層耗用大部份解碼開銷,Naive-N0.5-Flash 以 DSA 取代那些全局注意力層:輕量級索引器為完整嘗史評分,顱骨只在選定的 token 子集上計算注意力。索引器仍掃描完整歷史且保留完整 KV 快取,稀疏注意力大幅降低注意力運算與記憶體存取。[1]
為適應新的注意力結構,模型的持續預訓練分三階段進行,共 3.25 兆 token:500 萬 token 的索引器熱身、3 兆 token 的稀疏注意力訓練,以及 2,000 萬 token 的學習率遞減。官方表示,此過程同時呈現提升模型在人工智能研究與編程方向的能力。[1]
推理效能與定價
官方指出,為此模型而設的推理系統 NaiveRT 以人工智能為中心的研發方式建構與優化,結合 mega-kernel 融合、Programmatic Dependent Launch(PDL)與投機解碼,在標準模式下為每位用戶提供每秒 50 token,在超高速模式下最高達每秒 2,000 token。[1]
定價方面,官方表示除開放權重外還會提供 API 存取,輸入、輸出與快取讀取每百萬 token 分別為 0.10、0.40 與 0.01 美元。[1]
授權與致謝
Naive-N0.5-Flash 以 MIT 授權釋出。官方在致謝中指出,模型建基於開源社群的成果:感謝小米 MiMo 團隊公開 MiMo-V2.5 基礎模型、DeepSeek 團隊在稀疏注意力方向的研究,以及 SGLang 團隊與社群的開源推理基建。[1][2]
參考資料
[1] Hugging Face — NaiveAI/Naive-N0.5-Flash 模型卡
[2] GitHub — NaiveAI-Labs/Naive-N0.5-Flash