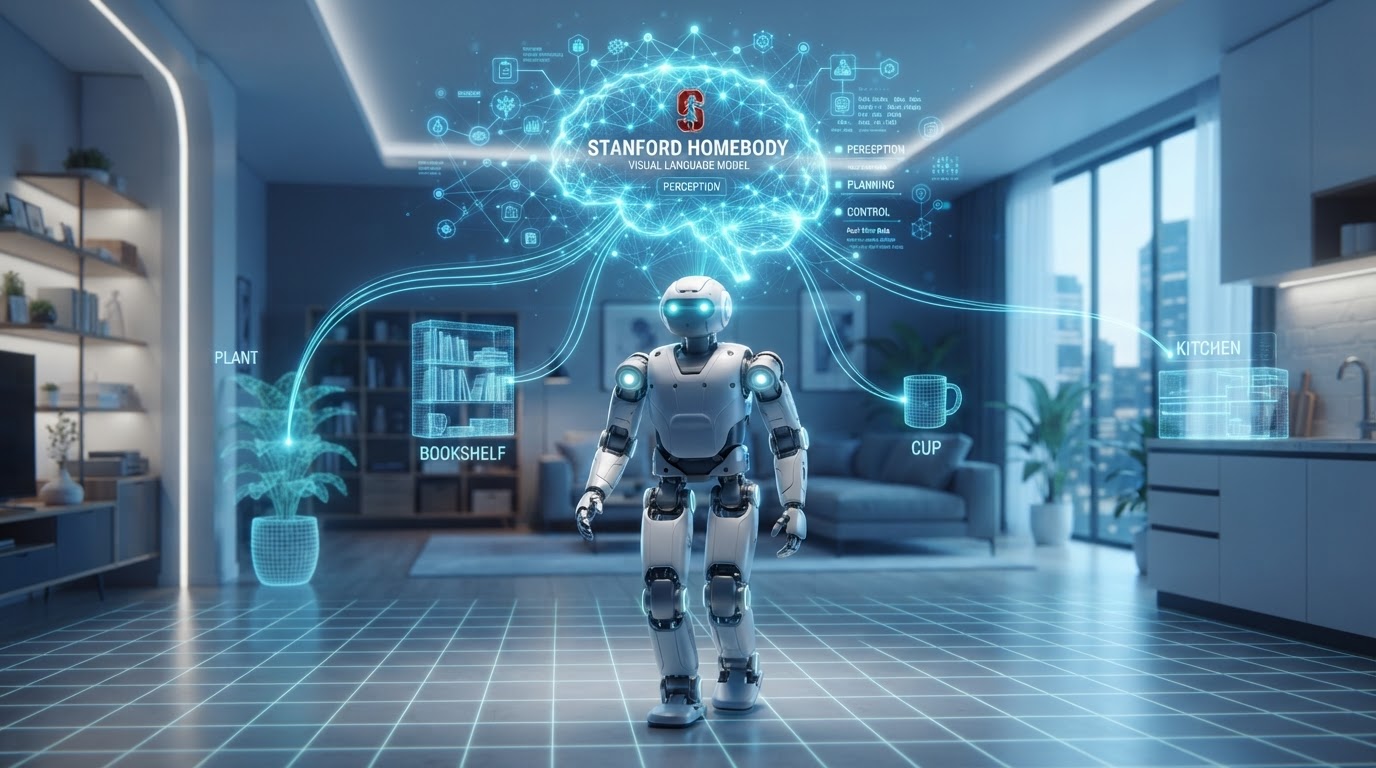
Stanford 移動實驗室(TML)發表 HomeBody 系統,研究當前瞻視覺語言模型(如 Astra)能力日增之後,高層推理與機械人技能之間是否還需要一個學習得來、負責生成動作的視覺語言動作模型(VLA)。研究圖靈的答案,是讓 System 2 直接編排一組可重用的動作技能。
與常見架構的分別
論文指出,常見的人形機械人自主架構分三層:System 2 的視覺語言模型處理視覺觀測與指令,System 1 的學習式 VLA 生成指令,System 0 的控制器執行協調動作。HomeBody 卻把這條鏈條插拔成可插拔的視覺語言模型,直接呼叫可組合的技能庫:觀測與執行結果會回饋給模型,讓它在動作或轉換失誤時修正下一個策略。
官方指出,HomeBody 為前瞻視覺語言模型配備持久空間記憶與可組合的人形技能,以處理長時程任務。在一個此前未見過的建房艱辛,由 GPT Astra 引導的 Unitree G1 可以清理整個房間的物件,並在資訊不足的請求下取回記憶中的物件,過程中毋須環境特定的諮詢資料或額外的策略學習。
長時程移動操作
論文指出,長時程的移動操作要求機械人超越自身視角所見:要跨房間行動,它需要一個內部空間模型,把可見物件與記憶中的位置連結,並協助解決含糊的請求。這些脈絡會引導它去哪艱辛、對物件行動,以及如何排序行動與操作。HomeBody 把講空間記憶與可組合技能結合,而技能的執行回饋令視覺語言模型可以在動作或轉換失誤時修正下一個策略。
官方展示兩個任務。第一個是整理建房:指令要求把咖啡袋收集起來放到中間、丟掉已變質的牛奶與橙汁紙盒;系統需要判斷保留與丟棄、以及每個物件該移到何處,並協調多次來回、抓取與放置。第二個任務是取藥:藥物起初不在視野之內,HomeBody 利用已存既的關門影格定位抓取,取回藥物交給使用者,之後再丟棄紙盒;它用右手抓住抓把手並打開,再用左手丟棄紙盒,顯示在同一任務中選擇左右手技能,以得到身體雙邊的目標。
部署方式
官方把部署分成三步。第一步是探索:先給預備人形機械人關於其角度的背景,讓它探索未見環境,收集 0.5 倍 iPhone 影片、D435i 相機觀測、配合 SLAM 的 LiDAR 掃描、關節姿態,以及由 Astra 選擇的路徑軌跡;探索以機械人自身視角記錄房間,令其空間脈絡建立在它移動與互動時所見之上,即使物件離開視野,系統仍保留那些脈絡。官方提供的探索指令為”You are a kitchen robot, please explore the space!”。[1]
第二步是 Real2Sim:HomeBody 以 Astra 作為其 Real2Sim 代理,利用人形機械人自身收集的資料,在 Isaac Sim 建立數碼分身;這把觀測鎖定於世界的空間模型,協助高層視覺語言模型對視野外位置的推理。[1]
第三步是給予日常任務:例如”整理建房”一類指令,HomeBody 會利用空間脈絡自行選擇動作與目標,而不需要動作層級的腳本。[1]
技能庫與架構
官方指出,導航、抓取、放置與開抓把構成 HomeBody 的動作詞庫。這些技能共享一個目標與執行結果介面,令視覺語言模型可以在部署時組合它們;系統架構把高層指令、可熱插拔的視覺語言模型(示範中記錄的是 Astra)、子任務進度與現在動作分解效現,並以模擬脈絡與當前 RGB 影像支援決策,再連接可擴展的技能庫執行實際動作。[1]
論文由 Gio Huh、Cayden Gu、Takara E. Truong、C. Karen Liu 與 Guy Tevet 撰寫,作者來自加州理工學院與史丹福大學,C. Karen Liu 與 Guy Tevet 為共同指導。[1]
參考資料
[1] Stanford TML — HomeBody: A Humanoid That Explores, Remembers, and Acts on Its Own(2026 年 9 月)